Какво е токенизация и защо е важна за езиковите модели?
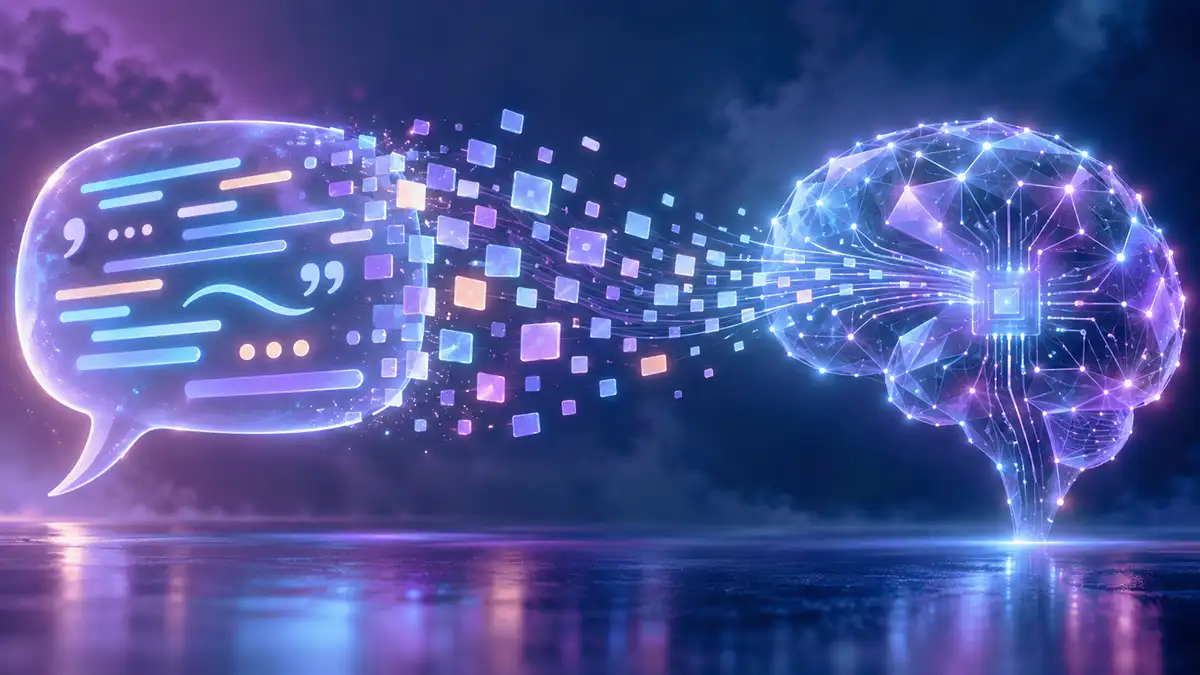
Когато пишем въпрос на ChatGPT или на друг езиков модел, ние виждаме изречение. За да може моделът да работи с него, текстът първо трябва да бъде преобразуван във форма, подходяща за математическа обработка. Това става чрез токенизация – разделяне на текста на по-малки единици, наречени токени. Те могат да бъдат цели думи, части от думи, числа, препинателни знаци или други знаци.
На всеки токен* се присвоява числов идентификатор, чрез който той се подава към модела за по-нататъшна обработка.
Една дума е различно от един токен
Да вземем изречението „Днес времето е хубаво.“. За човека то съдържа четири думи. Един езиков модел обаче може да го раздели на повече от четири токена, а друга система – по различен начин. Затова няма универсално правило „една дума = един токен“. Токенизацията може да се сравни с детски конструктор. Човек вижда завършената къща, но тя е построена от отделни тухлички, плочки и прозорци. По сходен начин текстът е цялото, което четем, а токените са по-малките елементи, с които работи езиковият модел.
Някои често срещани думи могат да бъдат представени като един токен. По-рядка или необичайна дума може да бъде разделена на няколко части. Затова два текста с приблизително еднаква дължина могат да съдържат различен брой токени в зависимост от езика, думите, правописа, символите и използвания токенизатор.
След токенизацията числовите идентификатори на токените се преобразуват в математически представяния, с които моделът може да извършва изчисления. Той анализира връзките между отделните елементи и използва закономерностите, усвоени по време на обучението, за да изчисли какво е вероятно да следва в дадения контекст. При създаването на отговор моделът генерира последователност от токени, които след това се преобразуват обратно в текста, който виждаме на екрана. Това не означава, че езиковият модел само „сглобява думи“. Изборът на следващ токен е резултат от сложни математически изчисления. Токенът е основна единица, чрез която текстът се представя пред модела и чрез която се генерира неговият отговор.
Защо броят на токените има значение?
Токенизацията може да изглежда като техническа подробност, но има пряко значение за работата с езиковите модели. Всеки модел може да обработва ограничено количество информация в даден момент. Този предел обикновено се определя чрез броя токени в неговия контекст. В контекста могат да попадат въпросът на потребителя, части от предишния разговор, системни и допълнителни инструкции, предоставени документи и генерираният отговор. Конкретният начин, по който се отчита това количество, зависи от използвания модел и услуга.
Затова два текста с еднакъв брой думи не е задължително да заемат еднаква част от наличния контекст. Разликата може да бъде особено видима при дълги документи, програмен код, таблици, числови данни, необичайни комбинации от знаци и различни езици или системи на писане. Броят на токените има значение и за цената при услуги, при които използването на модел се таксува според количеството обработен входен и генериран текст.
Различните модели и системи не използват непременно един и същ начин за токенизация. Една дума може да бъде един токен при един токенизатор и няколко токена при друг. Затова твърдения от типа „100 думи са точно 130 токена“ могат да служат само като приблизителен ориентир. Точният брой зависи от конкретния текст и от токенизатора. Токенизацията сама по себе си не прави един езиков модел интелигентен. Тя е техническият механизъм, чрез който написаният от човека текст се преобразува във форма, с която моделът може да работи, а полученият резултат отново се превръща в четим текст.
* Токен – единица, на която се разделя текста за обработка от езиковия модел. Токенът може да представлява цяла дума, част от дума, число, препинателен знак или друг знак.


